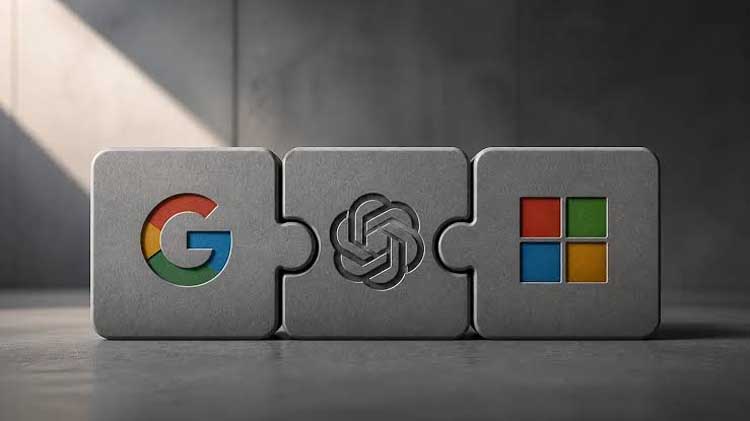
واشنگٹن (پاک ترک نیوز )مصنوعی ذہانت کی بڑی کمپنیوں گوگل، مائیکروسافٹ، اوپن اے آئی اور اینتھروپک نے ویب سائٹس کے مواد کو مصنوعی ذہانت کے ماڈلز کی تربیت میں استعمال کرنے سے روکنے کے لیے مشترکہ طریقہ کار اپنانے پر اتفاق کیا ہے۔
نئے نظام کے تحت ویب سائٹس مالکان ایک مخصوص ہدایت کے ذریعے واضح کرسکیں گے کہ آیا وہ اپنی ویب سائٹس کا مواد مصنوعی ذہانت کے ماڈلز کی تربیت کے لیے استعمال کرنے کی اجازت دیتے ہیں یا نہیں۔
اس سے قبل ویب سائٹس مالکان کو ہر کمپنی کے ویب کرالر کے لیے الگ الگ ہدایات درج کرنا پڑتی تھیں، تاہم نئے طریقہ کار کے تحت ایک ہی ہدایت تمام شریک کمپنیوں کے لیے قابل قبول ہوگی۔
رپورٹ کے مطابق اینتھروپک نے اس نظام پر عمل درآمد شروع کردیا ہے، جبکہ اوپن اے آئی آئندہ چند ماہ میں اسے اپنانے کا ارادہ رکھتی ہے۔ مائیکروسافٹ یکم فروری 2027 سے اس پر عمل درآمد شروع کرے گی، جبکہ گوگل نے 2027 کا ہدف مقرر کیا ہے۔
دوسری جانب میٹا نے اس اقدام کی حمایت تو کی ہے، تاہم تاحال اس پر عمل درآمد کا باضابطہ وعدہ نہیں کیا۔
ماہرین کے مطابق یہ طریقہ کار ویب سائٹس کو مکمل طور پر ڈیٹا چوری یا خودکار رسائی سے محفوظ نہیں بنائے گا، بلکہ صرف یہ ظاہر کرے گا کہ ویب سائٹ کا مواد مصنوعی ذہانت کی تربیت کے لیے استعمال کیا جاسکتا ہے یا نہیں۔
اس نظام کے تحت ویب کرالر ویب سائٹ کا مواد حاصل کرنا جاری رکھ سکیں گے، جبکہ پہلے سے جمع کیے گئے ڈیٹا پر بھی اس کا اطلاق نہیں ہوگا۔
یہ طریقہ کار فی الحال انٹرنیٹ انجینئرنگ ٹاسک فورس کا باضابطہ منظور شدہ معیار بھی نہیں ہے۔
یہ بھی پڑھیں: مصر میں دو مسافر ٹرینیں آپس میں ٹکرا گئیں، 7 افراد ہلاک، 112 زخمی
ماہرین کا کہنا ہے کہ یہ اقدام ویب سائٹس کے مواد پر مالکان کے اختیار کو تسلیم کرنے کی جانب پیش رفت ہے، تاہم اس کی کامیابی کا انحصار بڑی ٹیکنالوجی کمپنیوں کی جانب سے رضاکارانہ عمل درآمد پر ہوگا۔